

Devin postentrenando un LoRA de FLUX en una GPU de Modal, desplegando el mejor checkpoint y agregándolo a una aplicación de chat
Antes de empezar
- Crea un puesto avanzado de Modal: ejecuta
uvx modal-devin inity elige una GPU para la aplicación de Modal generada. Consulta Ejecutar Devin en Modal y el inicio rápido de Outposts. - Conecta tu repositorio: el de la aplicación en la que quieres integrar el modelo. El video usa una aplicación de chat de demostración privada con un selector de modelos de imagen, clonada en un Modal Volume persistente. ¿No tienes una aplicación? Pide a Devin que primero cree una (por ejemplo,
build a simple chat app with a model picker that calls an image generation endpoint), u omite la aplicación y haz que Devin solo entrene y despliegue el modelo. - Prepara tus datos de entrenamiento: agrega imágenes con sus descripciones al repositorio o a un Modal Volume que monte el puesto avanzado. El ejemplo usa 18 imágenes de nutrias en estilo de dibujos animados con descripciones como «Devin the software engineer in a data center».
- Secretos: no necesitas credenciales adicionales; el sandbox de Modal ya incluye credenciales de Modal, por lo que Devin puede entrenar y desplegar endpoints sin configurar nada más. El video también registra el entrenamiento en Weights & Biases; si quieres hacer lo mismo, agrega
WANDB_API_KEYen Configuración > Secretos antes de empezar; si no, omite este paso. - Define reglas para ejecuciones largas: agrega reglas de organización (o inclúyelas en el prompt), por ejemplo: publicar una actualización del progreso cada 15 minutos, generar imágenes de validación en cada checkpoint e incluir el enlace de vista previa en cada PR.
- Conecta Slack (opcional): las ejecuciones de entrenamiento tardan horas, así que sincroniza la sesión con un hilo de Slack para seguir su avance.
Paso 1: Inicia una sesión en el puesto avanzado
Abre Devin, elige tu puesto avanzado de Modal en el menú Virtual environment, situado debajo del cuadro del prompt, y activa el interruptor de Slack en el editor. Comprueba el hardware:Paso 2: Revisa los datos de entrenamiento
Paso 3: Inicia la ejecución de entrenamiento
otterchat es la aplicación de demostración del video; usa el nombre de tu propio repositorio.
Devin ejecuta el job por su cuenta, siguiendo las reglas anteriores:
- Entrena el LoRA: unos 1,000 pasos, con renderizados de validación cada 100 pasos (y métricas en Weights & Biases si agregaste la clave).
- Informa en Slack: comparte el progreso cada 15 minutos junto con los renderizados más recientes. Los primeros renderizados muestran personas; la nutria va apareciendo a medida que avanza el entrenamiento.
- Elige el mejor checkpoint: el del paso 700, ya que los pasos 900 y 1,000 mostraron indicios de sobreajuste.
- Despliega y publica: sirve el paso 700 como un endpoint serverless de Modal, agrega
otterimage 1.0al selector de modelos de la aplicación de chat, graba una prueba de extremo a extremo y abre un PR con un enlace de vista previa.
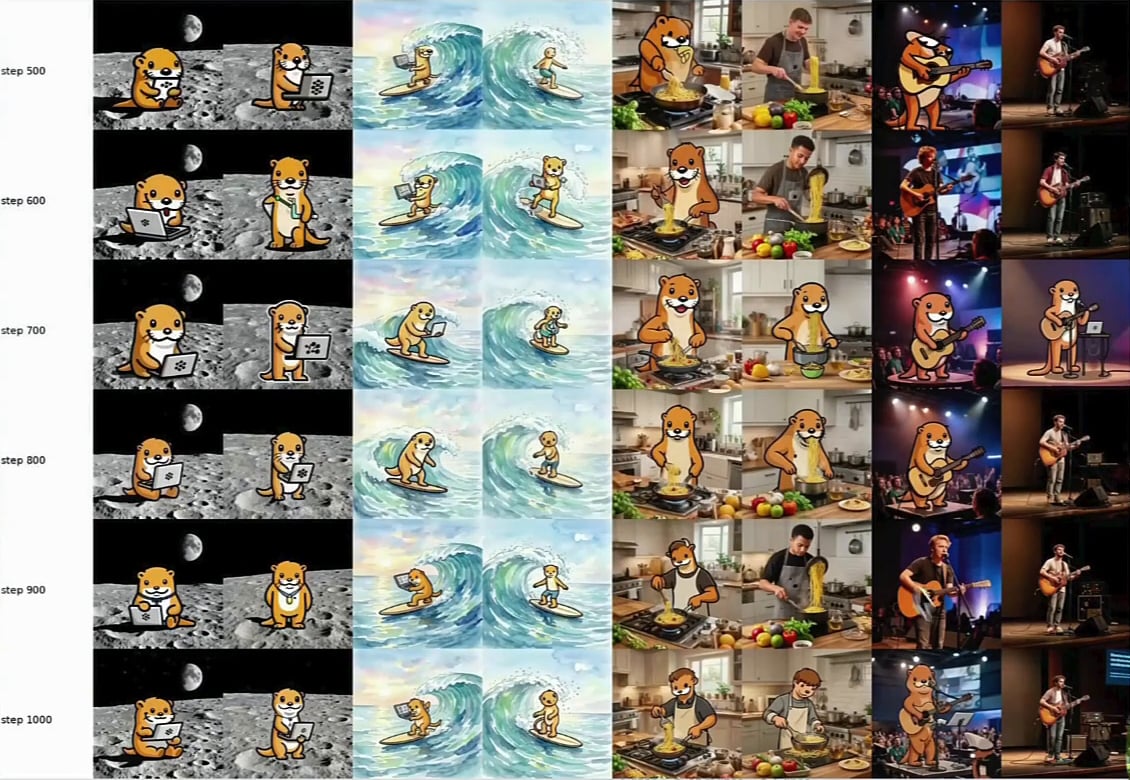
Renderizados de validación del paso 500 al paso 1,000
Paso 4: Prueba el modelo
Abre el enlace de vista previa del PR y pide una imagen: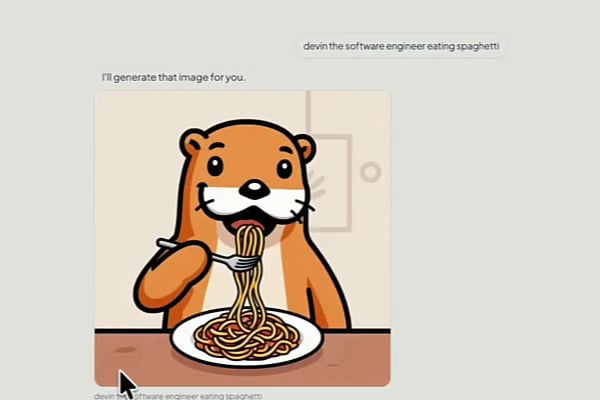
Paso 5: Itera con sesiones secundarias
El post-entrenamiento rara vez se resuelve en una sola ejecución. Pásale a Devin un artículo y deja que pruebe las alternativas en paralelo: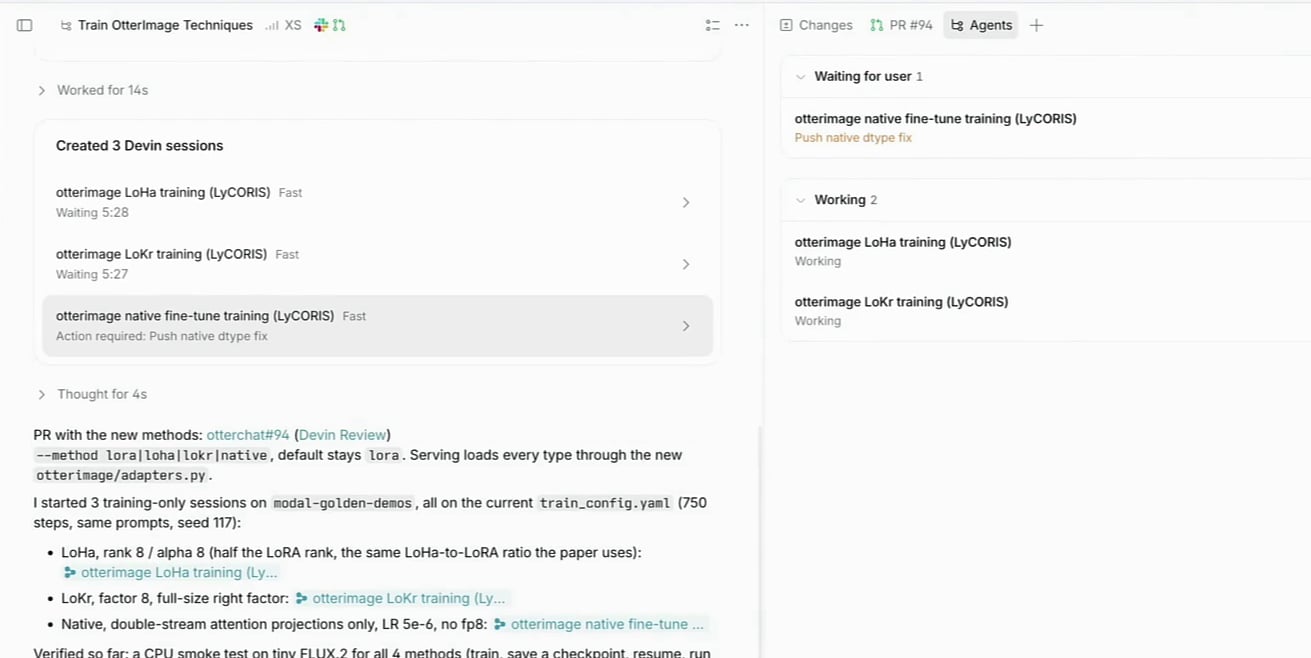
Próximos pasos
Ejecutar Devin en Modal
Crea un puesto avanzado basado en Modal con GPU, Volumes y Secrets
Devin Outposts
Ejecuta sesiones en tu propia infraestructura o en la plataforma de un partner
Integración con Slack
Haz seguimiento de sesiones de larga duración desde un hilo de Slack
Devins gestionados
Inicia y supervisa sesiones secundarias para realizar experimentos en paralelo