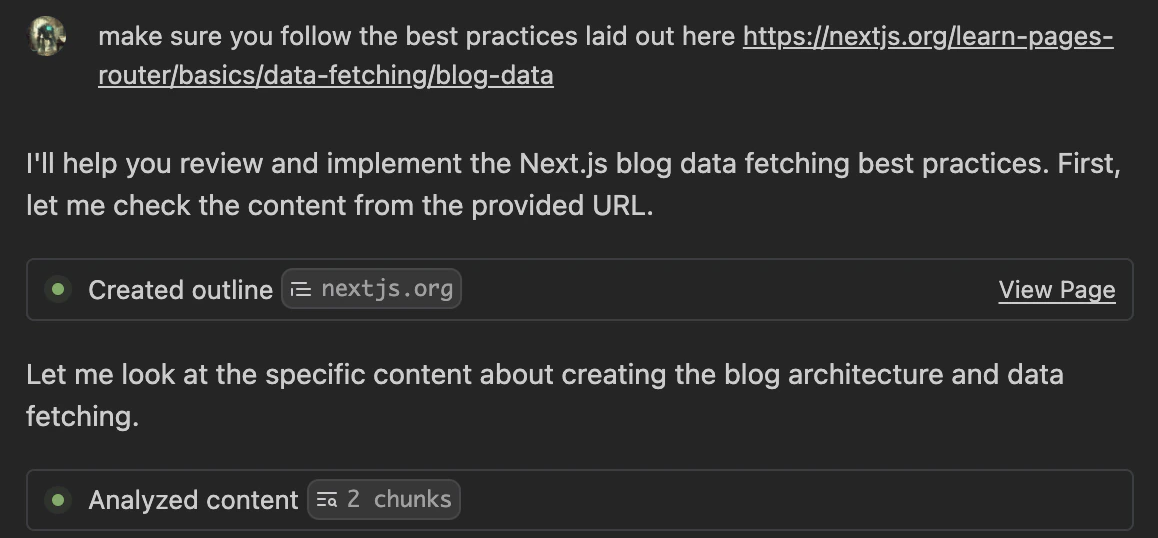
Cascade は、Web ページやドキュメントを直感的に解析して適切な単位に分割し、モデルにリアルタイムの前提情報を提供できるようになりました。この機能を理解するうえで重要なのは、Cascade が人間のようにインターネットを閲覧するということです。 当社の Web ツールは、クレジットを効率的に利用できるよう、必要な情報だけを取得するよう設計されています。 Devin Local agent には、Devin CLI の権限システムによって管理される、独自の Web 取得ツールと検索ツールがあります。

概要

Web検索 がどのように機能するのかをより深く理解していただくために、基本的な考え方とベストプラクティスを紹介する短い動画をご用意しました。

クイックスタート

すぐに使い始めるには、エディタ右下の Devin Settings でウェブ検索を有効にします。有効にする方法は複数あります。
  1. インターネットが必要そうな質問をします (例: “React の最新バージョンでは何が新しくなりましたか?”) 。
  2. @web を使ってウェブ検索を強制します。
  3. @docs を使って、高精度で読み取れることが確認できているドキュメントのリストをクエリします。
  4. メッセージに URL を貼り付けます。

Web を検索

Cascade は、ユーザーからの特定のプロンプトに対して最適な応答を返すには、リアルタイムの ウェブ検索 が必要だと判断することがあります。その場合、Cascade は ウェブ検索 を実行し、その結果をユーザーに提供します。これは自動的に行われることもあれば、@web メンションを使って手動で行うこともできます。
Enable ウェブ検索 管理者設定では、チーム全体で Cascade の Web ツールを制御します。無効にした場合:
  • Cascade は公開インターネット上で ウェブ検索 を実行できません。ウェブ検索ツールはサーバー側で Cascade のリクエストから取り除かれるため、個々のユーザーが再度有効化することはできません。
  • Cascade は引き続き特定の URL を読み取ることができます (詳しくは下記のページの読み取りを参照してください) が、ページの読み取りごとに手動での承認が必要になります。Always allow this page および Allow all requests のオプションは利用できず、ユーザーの Web リクエストに対する自動承認設定も無視されます。
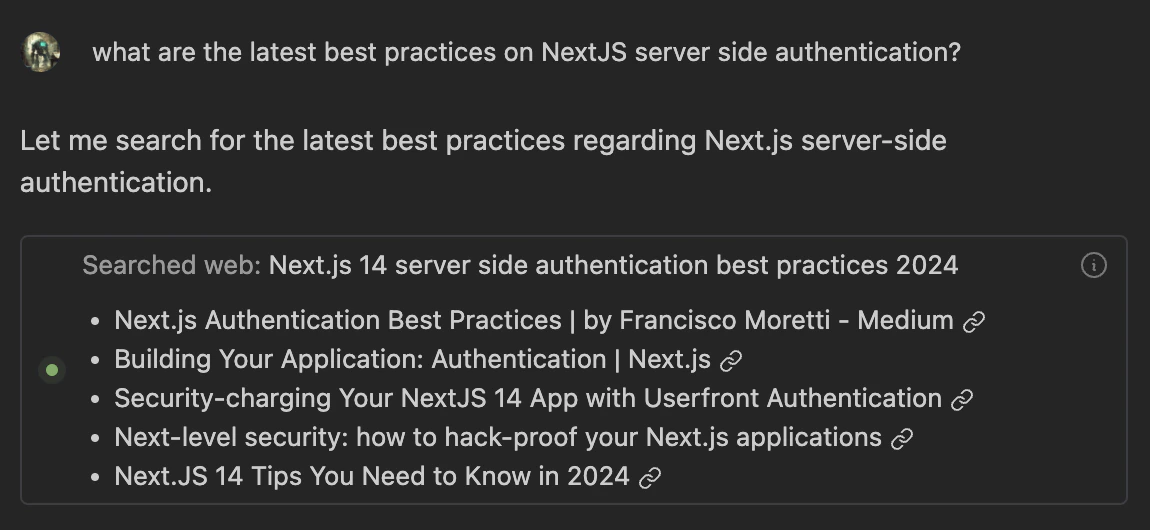
ページの読み取りは、引き続きユーザーのマシン上でローカルに実行されます。

ページの読み取り

Cascade は、ドキュメント、ブログ記事、GitHub 上のファイルなど、個別のページを読み取ることができます。ページの読み取りはネットワーク内のご利用中の端末上で完結するため、VPN を使用していても問題ありません。 ページは、Web の検索結果、会話の内容からの推定、またはメッセージに直接貼り付けた URL から取得されます。 ページは複数のチャンクに分割されます。これは、人がページを読む方法とよく似ています。長いページでは、まず目的のセクションまでざっと目を通し、その後で関連するテキストを読みます。Cascade も同じように動作します。
なお、すべてのページを解析できるわけではありません。現在、Web サイト読み取りの品質向上に継続的に取り組んでいます。より適切に対応してほしい特定のサイトがあれば、ぜひ機能リクエストをお寄せください。