> ## Documentation Index
> Fetch the complete documentation index at: https://docs.devin.ai/llms.txt
> Use this file to discover all available pages before exploring further.
# Adaptive
> Adaptive es el router inteligente de modelos de Cognition que selecciona automáticamente el mejor modelo de IA para cada tarea.
Seleccionar Adaptive
Para usar Adaptive, abre el selector de modelos debajo del cuadro de entrada del agente y selecciona **Adaptive** en la parte superior de la lista. Una vez seleccionado, Adaptive se usará en todos los mensajes siguientes de la conversación.
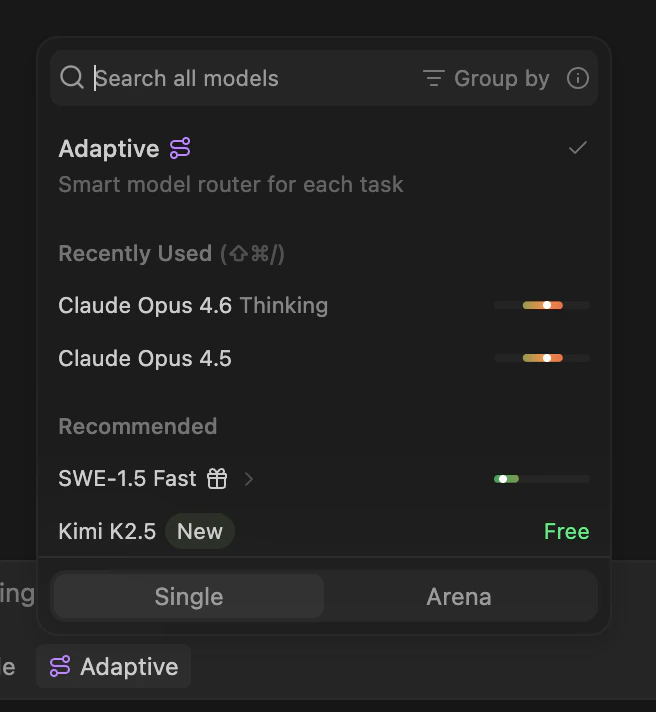 Puedes cambiar de Adaptive a un modelo específico en cualquier momento.
Adaptive es un enrutador inteligente de modelos que selecciona automáticamente el mejor modelo de IA para cada tarea. En lugar de elegir manualmente entre decenas de modelos, Adaptive analiza tu prompt y lo encamina al modelo que ofrecerá el mejor resultado.
Cómo funciona
Cuando seleccionas **Adaptive**, Devin evalúa cada solicitud y elige dinámicamente el modelo subyacente adecuado. Las tareas sencillas se asignan a modelos rápidos y eficientes. Las tareas complejas se asignan a modelos más capaces.
Esto significa que obtienes el nivel adecuado de inteligencia para cada prompt sin gastar de más en modelos prémium para tareas rutinarias. Adaptive ayuda a que tu cuota de uso incluida dure más al evitar el uso innecesario de modelos costosos.
Para la mayoría de los usuarios recomendamos Fusion: combina un modelo principal de frontera con un asistente eficiente en costos. Consulta [Fusion en Devin CLI](/es/cli/fusion) y [Fusion en Devin Desktop](/es/desktop/fusion).
Disponibilidad para Enterprise
Para las organizaciones Enterprise, Adaptive está deshabilitado de forma predeterminada. Un Admin debe habilitar la opción **Adaptive model router** en la página de Settings de Enterprise antes de que los miembros del equipo puedan seleccionar Adaptive en el selector de modelos.
* **Devin Desktop**: Ve a **Settings > Devin Desktop > Models** y activa **Adaptive model router**.
* **Windsurf**: Ve a **Team Settings > Models** y activa **Adaptive model router**.
Si Adaptive aparece como no disponible después de habilitarlo, revisa tus restricciones de modelos. Adaptive distribuye las solicitudes entre un pool de modelos, por lo que esos modelos deben estar permitidos para tu equipo.
Precios
Los precios de Adaptive dependen de tu plan de facturación.
Adaptive consume tu cuota a una **tarifa fija por token**, independientemente del modelo subyacente que se seleccione para una solicitud determinada.
| Tipo de token | Costo por 1 millón de tokens |
| :- | :- |
| Tokens de entrada | \$0.50 |
| Tokens de salida | \$2.00 |
| Tokens de lectura de caché | \$0.10 |
Estas tarifas también se aplican al uso adicional que exceda tu cuota incluida.
Como Adaptive enruta las tareas más simples a modelos más ligeros, normalmente consume menos tokens en total que seleccionar manualmente un modelo frontier para cada solicitud. Esto lo convierte en la opción más rentable para la mayoría de los usuarios.
Para los clientes de la plataforma Cognition, el uso de Adaptive se mide en **ACUs** (Agent Compute Units). El consumo de ACU varía según los tokens usados y el modelo que el enrutador seleccione para cada solicitud.
Para los clientes Enterprise con facturación basada en créditos, Adaptive usa **precios variables por token en créditos**. Cada solicitud consume créditos según los tokens reales usados y el modelo que Adaptive selecciona para esa solicitud, de acuerdo con tu tarifa de créditos.
Esto significa que los modelos más baratos cuestan menos créditos por solicitud, y el enrutamiento de Adaptive favorece de forma natural las opciones más eficientes en costos, por lo que tu saldo de créditos dura más en comparación con seleccionar siempre un modelo prémium.
Consejos para sacar el máximo provecho de Adaptive
* **Sé específico con tus prompts.** Las instrucciones claras y precisas ayudan a Adaptive a enrutar la solicitud al modelo adecuado y a reducir el uso innecesario de tokens.
* **Aprovecha el almacenamiento en caché de prompts.** Mantener el mismo modelo a lo largo de los turnos de una conversación permite usar la caché, lo que reduce significativamente los costos de los tokens de entrada. Adaptive lo tiene en cuenta al enrutar las solicitudes.
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.